Nana Fujiwara
架空の銀行を題材に、リリース後のAPI障害をGrafanaで検知・原因特定・復旧する流れを動画で紹介。SIOSのGrafanaライセンス販売・OSSサポート・価値検証(PoV)もご案内します。
“架空の銀行を題材に、リリース後のAPI障害をGrafanaで検知・原因特定・復旧する流れを動画で紹介。SIOSのGrafanaライセンス販売・OSSサポート・価値検証(PoV)もご案内します。”
はじめに:APIの「リリース直後」に起きること
APIは、アプリや社内システム、パートナー連携を支える基盤です。その分、リリースや設定変更をきっかけに、一部のリクエストだけが失敗するといった障害が起きやすい領域でもあります。こうした障害は、全体のエラー率を見ているだけでは気づきにくいことがあります。
この記事では、Grafana Labs社のデモ動画を紹介します。架空の銀行を題材に、リリース後の障害を「検知、原因特定、復旧」する流れを約75秒で見られます。後半では、サイオスがGrafanaでご支援できる内容もご紹介します。
▶ 動画が表示されない場合は、こちら(YouTube)からご覧ください。
動画のあらすじ:架空銀行の「ある一日」
動画の舞台は、架空の銀行「Nusa Bank」です。登場するデータはすべて合成データで、実在の企業・実際の障害ではありません。時刻はすべてシンガポール時間(SGT)です。
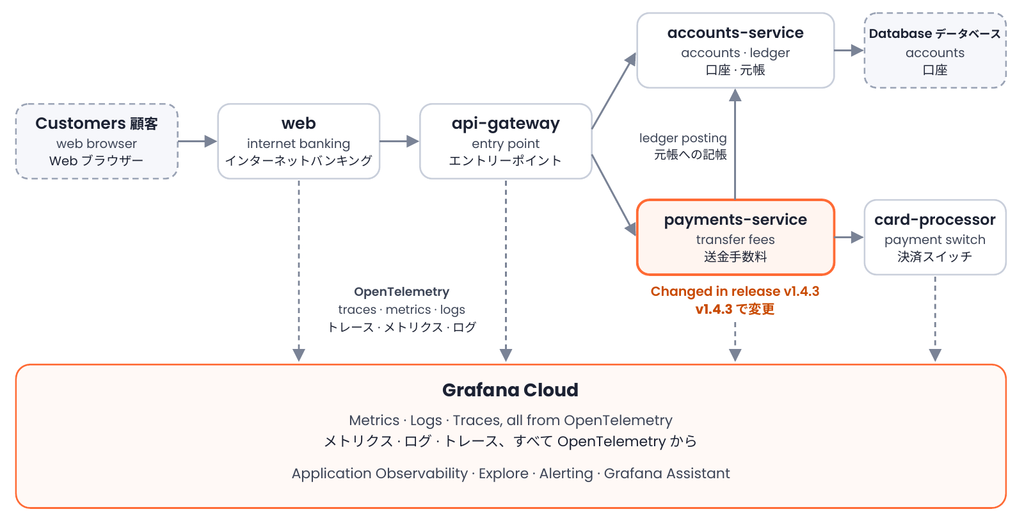
Nusa Bankのシステム構成。5つのサービスが、OpenTelemetryでGrafana Cloudにデータを送ります。オレンジの枠は、リリース(v1.4.3)で変更されたpayments-serviceです。
| 時刻 | 出来事 | 使われている機能 |
|---|---|---|
| 日中 | 5つのサービスがすべて正常(エラー率 0%) | OpenTelemetryでデータをGrafana Cloudへ送信 |
| 22:44 | payments-serviceがv1.4.2からv1.4.3へリリース(手数料ティアの見直し) | — |
| 22:46 | S$2,000を超える送金がすべて失敗。送金全体の約30%が失敗 | Application Observabilityのダッシュボード |
| 22:48 | エラー率が1%を超え、アラート発火 | Grafana Alerting |
| 22:51 | オンコールSREがスマホでアラートを確認 | モバイル通知 |
| 22:58 | ノートPC、VPN、サインインを済ませ、Grafanaでアラートを開く | Grafana |
| 23:00 | 顧客の報告内容を普通の言葉でAssistantに質問 | Grafana Assistant |
| 23:03 | 原因を特定(手数料ティアの設定で、S$2,000超のティアがなく、エラーになっていた) | Grafana Assistant |
| 23:06 | SREが証拠を添えて、決済エンジニアリングチームに連絡 | — |
| 23:12 | 緊急変更を承認し、ロールバック開始 | — |
| 23:15 | v1.4.2が本番に復帰 | — |
| 23:18 | エラー率が0%に回復したことをSREが確認 | Grafana |
技術的には専門的な内容ですが、言い換えると「新しい設定で、高額の送金だけが通らなくなった」ということです。全体のエラー率だけを見ていても、一部の条件で起きる問題は見落としやすくなります。
画面で見る:リリースからアラートまで
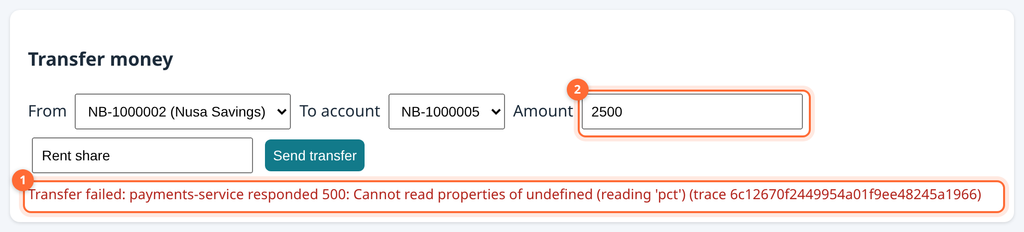
顧客の画面。リリース前は手数料S$5.00で完了していた同じS$2,500の送金が、リリース後はエラーで失敗します。

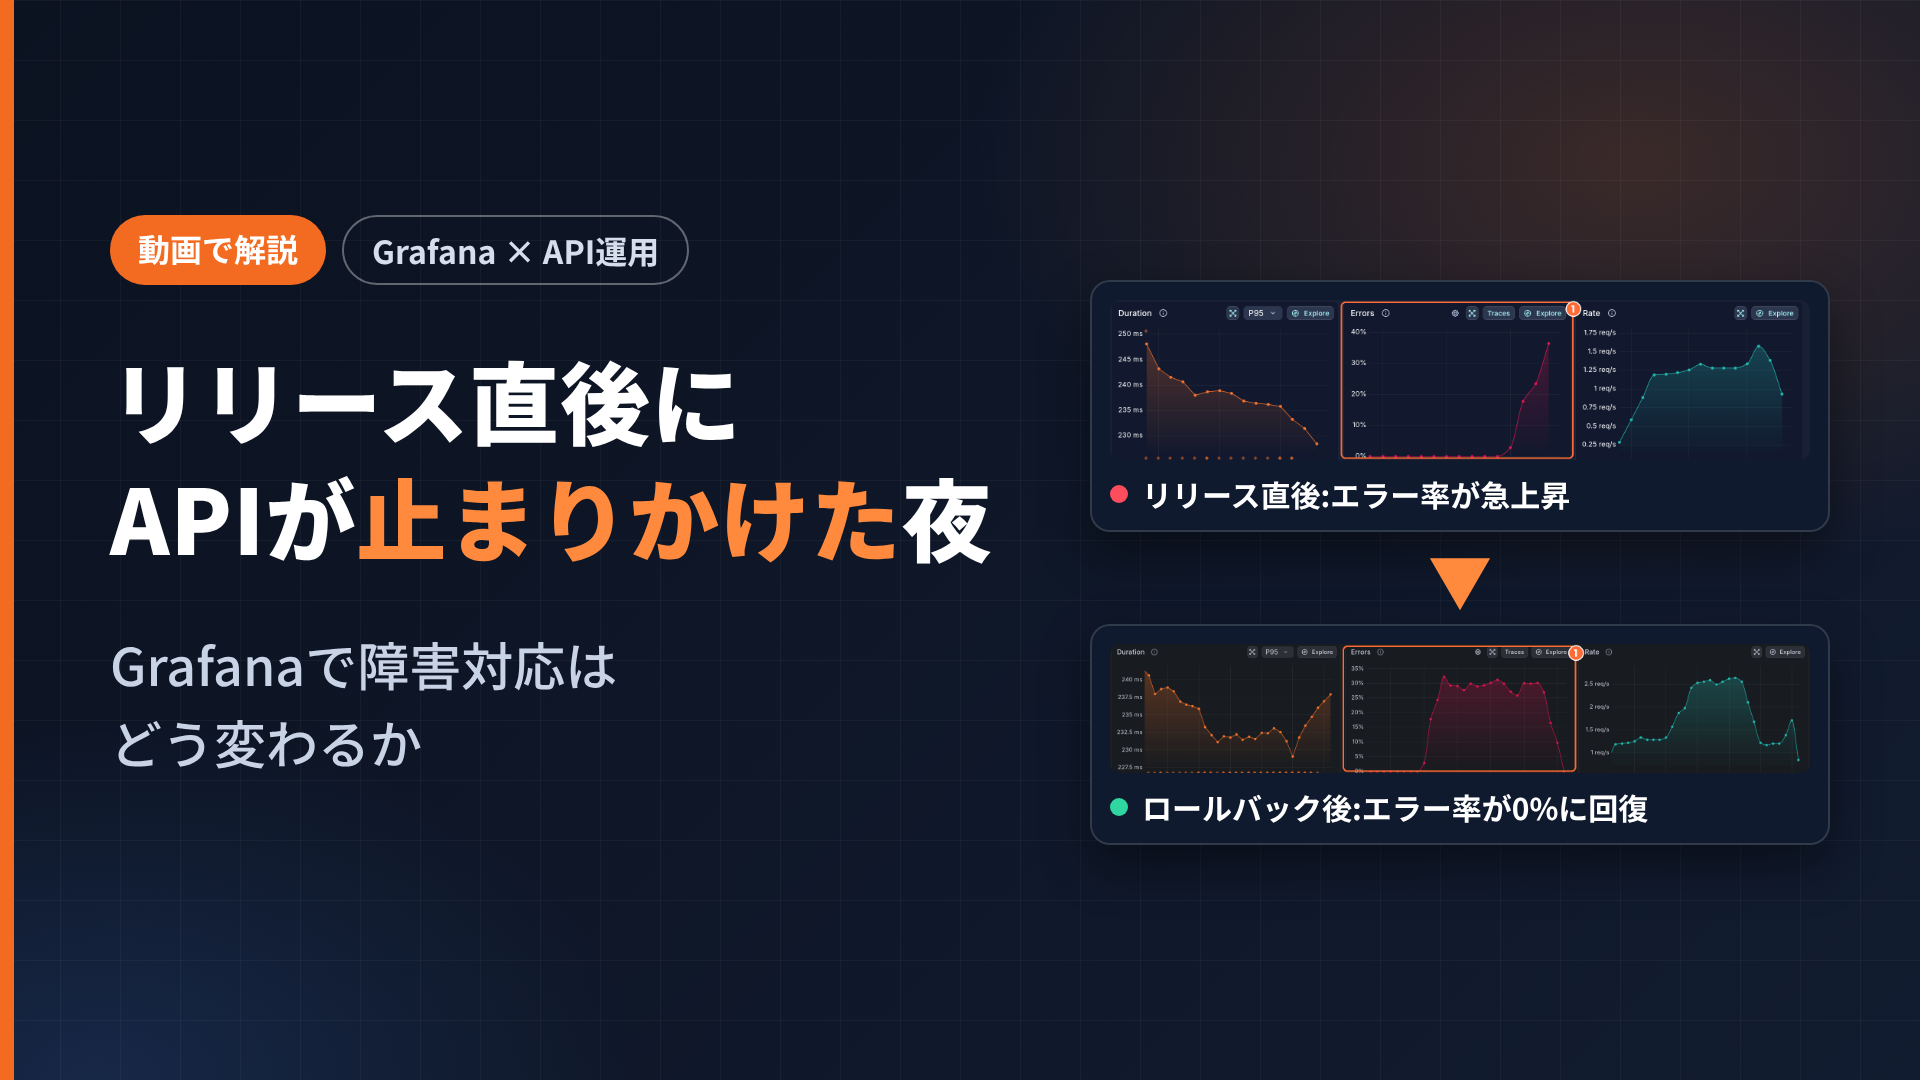
payments-serviceのエラー率(中央)は、リリース直後に0%から約36%まで上昇します。一方、レイテンシ(左)は正常のままです。

アラートの対象であるpayments-serviceの5xxエラー率(%)。リリース直後にしきい値の1%を超え、約30%まで上がり続けます。
出典:Grafana Labs社のデモ動画。時刻表は一般的なオンコール対応の例で、画面は同じリリースのデモ実行のため、画像内の時刻が表と異なる場合があります。
動画から読み取れる3つのポイント
1. 一部のリクエストだけの障害も、アラートで拾える
動画では、「エラー率が1%を超えたら通知」というアラートルールが事前に用意されています。ユーザーからの問い合わせを待たずに、障害を知らせる仕組みです。
2. 原因特定を、普通の言葉で始められる
動画では、質問に金額やバージョンを書かずに、「送金が失敗している」という状況を伝えるだけで調査が始まります(Grafana Assistant)。メトリクス、ログ、トレースをもとに、約3分で原因候補が示されます。実行したクエリも表示されるため、エンジニアが根拠を確認できます。なお、コードの該当行までの特定には、ソースリポジトリの接続が必要です(読み取り専用で、コードは変更しません)。
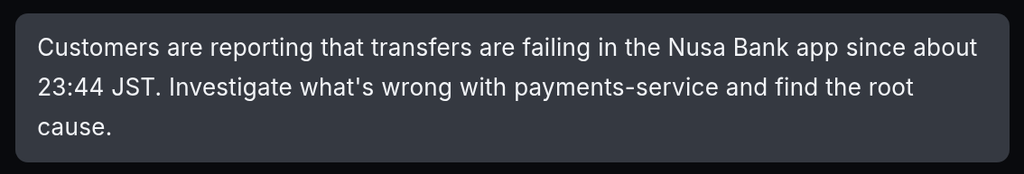
Grafana Assistantへの質問。金額・バージョン・リリースには触れず、顧客からの報告内容だけを普通の言葉で伝えています(英語で入力)。
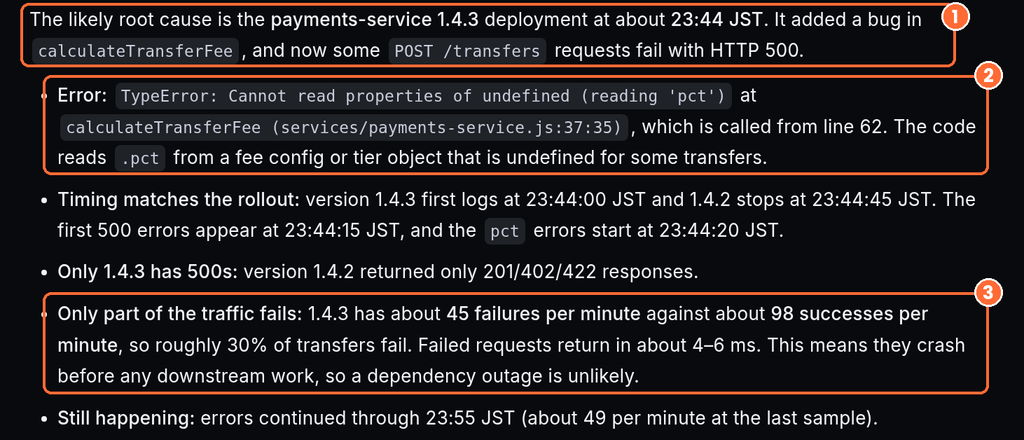
Assistantの回答(約3分)。①最も可能性の高い原因はpayments-service 1.4.3のリリース、②例外の発生箇所はcalculateTransferFeeの37行目、③送金の約30%が失敗しており、他の箇所の障害の可能性は低い、と示されます。画像内の時刻は日本時間(JST)の表記で、シンガポール時間の22:44は日本時間の23:44にあたります。
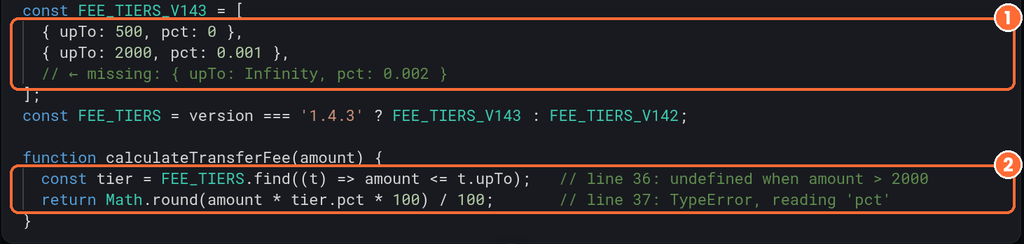
Assistantが示したv1.4.3の手数料テーブル(ソースリポジトリ接続後のフォローアップセッションで取得)。①S$2,000を超えるティアがなく、②36行目の検索が何も見つけられないため、37行目でエラーになります。
3. 復旧の確認も、同じツールでできる
ロールバック後のエラー率が0%に戻ったことも、同じダッシュボードで確認できます。
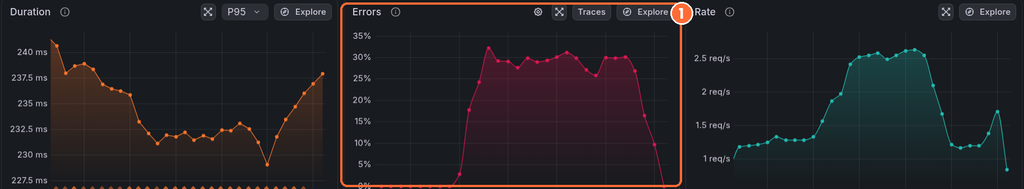
payments-serviceのエラー率(中央)。リリース前は0%、リリース後は約30%、v1.4.2に戻ると0%に回復します。
動画内では、このシナリオでの所要時間として次の数字が示されています。
| 区間 | 動画内の所要時間 |
|---|---|
| リリース→アラート | 約4分(22:44→22:48) |
| アラート→根本原因 | 約15分(22:48→23:03。アラートの確認とサインインを含む。Assistantの回答自体は約3分) |
| リリース→復旧 | 約34分(22:44→23:18) |
これらは、架空シナリオにおけるデモ上の数字で、時刻は一般的なオンコール対応の例です。実際の導入効果を示すものではありません。現場では、システム構成や連携範囲によって結果は異なります。
影響範囲も、動画の中でデータから示されます。失敗したのはS$2,000を超える送金だけで、Assistantが分析したデータでは、v1.4.3上の高額送金594件がすべて失敗し、v1.4.2では267件がエラーなしで処理されました。送金エンドポイント(POST /transfers)のエラー率は、最大で約36%でした。
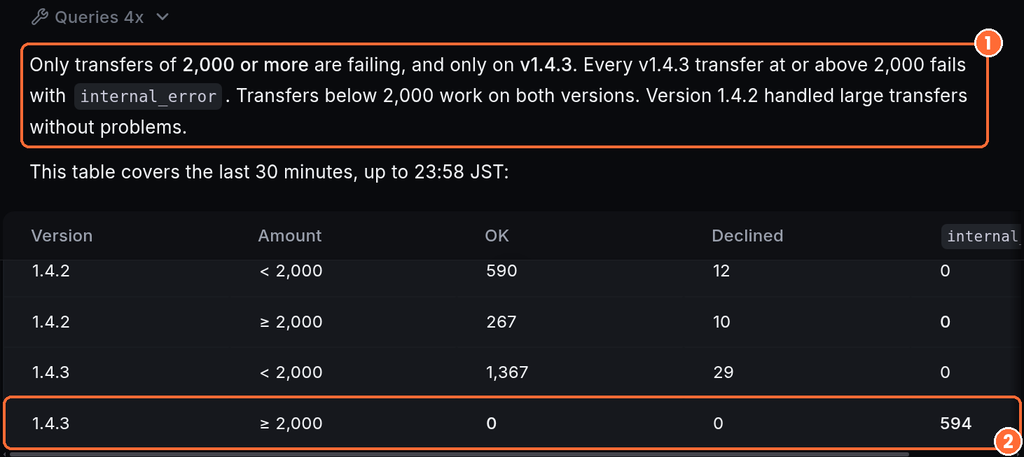
バージョン・金額別の送金結果。v1.4.3では、S$2,000以上の送金594件がすべて失敗しています(下段)。v1.4.2では、同じ金額帯の267件がエラーなしで成功しています。
サイオスがGrafanaでご支援できること
サイオステクノロジーでは、Grafanaに関する次の3点をご支援しています。“いきなり導入”ではなく、現在の運用状況のご相談から始められます。
Grafana Labs社は、動画のデモがOpenTelemetryと、オープンソースのGrafana、Prometheus、Loki、Tempoを基盤にしており、テレメトリを他の環境へも持ち出せると説明しています。OSS版をお使いの方は、サイオスのOSSサポートもご利用いただけます。
| 支援内容 | 概要 | こんな方に |
|---|---|---|
| Grafanaライセンスの販売 | Grafanaのライセンスをご提供します。 | 商用での利用を検討している方 |
| OSS版のサポート | OSS版Grafanaの利用をサポートします。 | 社内でOSS版を運用中で、保守体制に不安がある方 |
| Grafanaに関するご相談 | 導入・運用・ライセンス選定などのご相談を承っています。 | 「どこから始めればよいか」を整理したい方 |
たとえば、次のようなご相談をお受けしています。
- APIやマイクロサービスの状態を、一つの画面で見られるようにしたい
- 障害を、問い合わせより先に検知できるようにしたい
- OSS版を使っているが、サポート体制や商用ライセンスへの移行を検討している
サイオスから提供できるライセンスの種類はこちらをご覧ください。
価格、サポート範囲等、お気軽にお問い合わせください。
ご注意:動画で紹介したApplication ObservabilityやGrafana Assistantは、動画ではGrafana Cloudの機能として紹介されています。ライセンスの種類やOSS版ごとの利用可否は、上記のページまたはお問い合わせでご確認ください。
実際の環境で確かめる:価値検証(PoV)
動画では、自社のサービスで同じ成果を確かめる進め方として、4週間の価値検証(PoV)が紹介されています。サイオスでも、価値検証をご提供しています。基本は4週間で、ご要望に応じて、より長い期間でのご相談も可能です。
| 週 | ステップ | 内容(進め方の例) |
|---|---|---|
| 第1週 | 接続 | 重要なカスタマージャーニーを1つ、OpenTelemetryでGrafana Cloudに取り込む |
| 第2週 | アラート | 「正常」の定義を合意し、アラートを有効にする |
| 第3週 | 調査 | 実際の障害をGrafana Assistantで再現し、根本原因までの時間を計測する |
| 第4週 | 判断 | 合意した成功指標に照らして、技術責任者・ビジネス責任者と結果を評価する |
事前に合意する成功指標の例は、検知までの時間、根本原因までの時間、「どの顧客が影響を受けたか」に答えるまでの時間です。進め方の例は動画の台本によるもので、実際の内容はご要望に合わせてご相談します。
まとめ:まずは現状の整理から
動画のポイントは、「リリース後の障害を、問い合わせより先に検知し、同じツールで原因特定と復旧確認を行う」ことです。自社のAPIやシステムでどこまで実現できるかは、現在の監視状況によって異なります。
「Grafanaを使っているが、アラートやサポート体制に不安がある」「ライセンスの選び方がわからない」「まずは情報を整理したい」といった段階でも、お気軽にご相談ください。実際の環境での価値検証(PoV)のご相談も承ります。
関連記事
 2025.07.28Grafana翻訳記事Grafana 12.1 のリリース情報 : Grafana インスタンスの自動ヘルス チェック、Grafana Alerting のビューの合理化、視覚化機能の更新など
 2025.03.26Grafana翻訳記事Grafana 11.6 リリース: 新しいデータ ビジュアライゼーション機能、メトリクス データ ソースの LBAC、アラート機能の強化など
 2022.09.16Grafana翻訳記事Grafana Cloud メトリクス:監視すべきメトリクスとベストプラクティスへのガイド
 2024.02.23GrafanaProduct Releases翻訳記事Grafana 10.3 の新機能:Canvasパネルの更新、マルチスタック データソースなど